 山月行
Claude Code skill:四条规则与两个模式
Skill 是给 Agent 打包可复用流程的文件夹:描述、步骤,以及可选的脚本。这个格式已经开放成 Agent Skills 约定,Claude Code、Codex、Cursor 等都会读;发现路径和 frontmatter 各工具不完全一样,字段以各自文档为准。
这篇整理 Austin Marchese 2026 年 5 月的视频 How Anthropic Engineers ACTUALLY Prompt Claude Code:Anthropic 工程师怎么提示 Claude Code。我按字幕核对原话,调用字段对照 Claude Code 的 Skills 文档。下面用 Claude Code 当具体例子,讲四条规则和两个模式;视频里的 Barry、Eric 都是播放出来的 Anthropic 片段。
多数人第一次用 AI,是每件事新写一段 prompt。Austin 的观察是,人真正反复做的是同一类事。Anthropic 做 skill,就是把这类事收成可以点名的流程。
他借工程分享里的一张图,分成三层。第一层是模型。第二层是 agent 和 prompt,多数人停在这里。第三层是 skill,他叫做应用层。类比手机的那句是:Anthropic is building the phone itself. You have to create the apps. That’s the layer to control. Anthropic 在造手机,App 由你来写。要控制的是这一层。
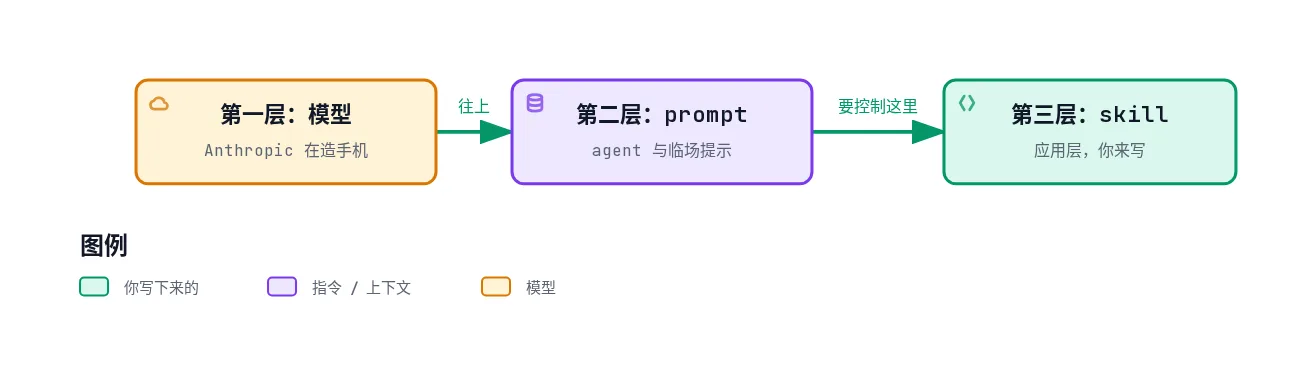
第一张图里,橙是模型,紫是临场 prompt,绿是你要写的 skill。后面几张:灰是起点,绿是写下来的 skill 或文件,紫是当次的 prompt 或对话,红是一次判断或反例,橙是脚本或工具。和 AGENTS.md 怎么写 是同一套底色。
这四条规则按我自己的仓库落地。规则一到规则三管 skill 怎么拆、description 怎么写、工具怎么做厚。两个模式管脚本放在哪、谁来点带副作用的命令。规则四是每次跑完之后的收尾。skill 正文和 AGENTS.md 用同一套写法:指针写清何时打开,步骤写到能判断做完,能用代码算完的交给脚本。
一、提示 skill
回一封邮件,常见做法是每次重写一段 prompt:用我的语气、按我的结构、先复述对方要什么。Austin 的例子是改成输入 slash draft email,再把原邮件带进来。我写成 /draft-email。语气和结构住在 skill 里,这一次只提供那封信。
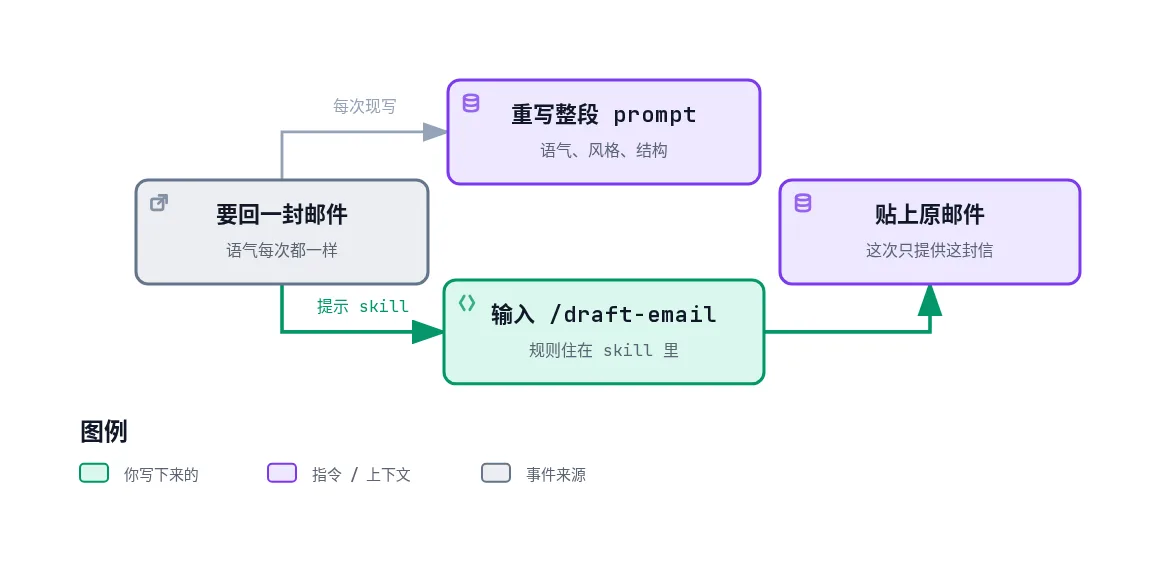
片段里的定义是:Skills are organized collections of files that package composable procedural knowledge for agents. Austin 把其中的 procedural knowledge 归于 Barry,并说 skill 就是文件夹:they’re folders.
我会把回信写成这样一份 description:起草回复邮件。用户贴来信、说帮我回、或要一封按既定结构写的回复时使用。 正文里只留稳定的步骤:先复述对方的请求,再给一个可执行的下一步,收尾落在时间点上。这些句子写一次。下一封信只把原文贴进来。
点名有两种。一种是你输入 /draft-email。另一种是 description 写得够具体,模型自己判断该打开它。规则二写的就是这张「文件夹标签」要具体到什么程度。
二、三层里,杠杆在工具
让 Claude Code 写一个 skill,它会给你一个文件夹。文件夹在,不等于这件事能被稳定做完。Austin 把里面拆成三层。
第一层是 description。他比作文件夹上的标签。模型每次决定用不用这个 skill,看的是标签。标签含糊,它对不上场合;标签具体,它知道何时该打开。标签写具体之后,你不必每次用斜杠点名。
第二层是 instructions。skill 被选中之后的 playbook,按步骤把事做完。
第三层是 tools。脚本、API、参考文件。他的原话是 this layer three is where most of the leverage lives, but most people stop at that layer two. 杠杆在第三层,多数人停在第二层。
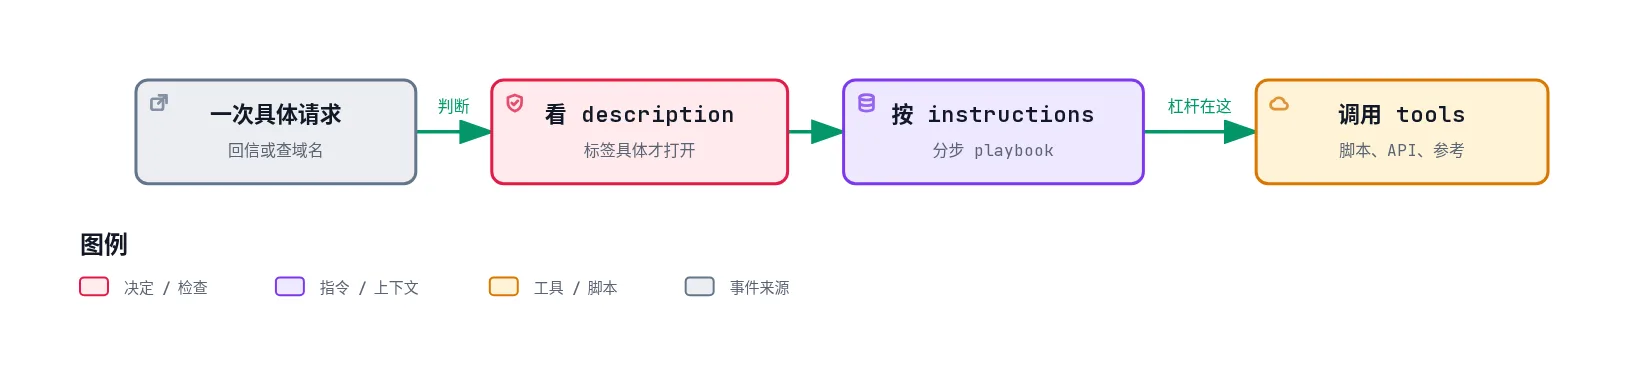
这和写给 Agent 读的文档是同一套分层。writing-for-agents 把常驻上下文的那一行叫指针:它要写清「什么情况下打开」,正文才是打开之后的步骤。官方加载规则对此是对齐的。平时进上下文的是 description,SKILL.md 正文在调用时才加载。description 和 when_to_use 拼在一起,在技能列表里截断到 1,536 字符,所以关键用例放在前面。
description 是指针。第一句写触发,后面再写边界。正文是步骤,每一步写到能判断做完没有。「理解用户语气」收不了工;「回信先复述对方的请求,再给出一个可执行的下一步」可以。模型默认就会做的句子整句删掉,例如「请认真回复」。能用一句话说清的目标,用一个词反复钉住,例如每个步骤下面的「完成的标志」。
视频里 Eric(Anthropic)讲了一个他觉得最好笑的反差。字幕原话是:人们会花很大力气写 really beautiful, detailed prompts;给模型的工具却 incredibly bare-bones,no documentation,the parameters are named A and B。参数叫 A 和 B、没有文档的函数,工程师自己也接不下去。
Austin 自己的例子是查域名。他不再跟模型来回猜一个名字能不能注册,而是给 skill 一个可以程序化查询的工具,查到的结果里已经核对过能买。这种重复劳动可以放大:10 different sub agents using this skill to look through 10,000 plus domains。他接着说,这是 something that I literally would have never been able to do before。十个子代理扫一万多个域名,靠的是工具,把查询从 prompt 里拿出来。
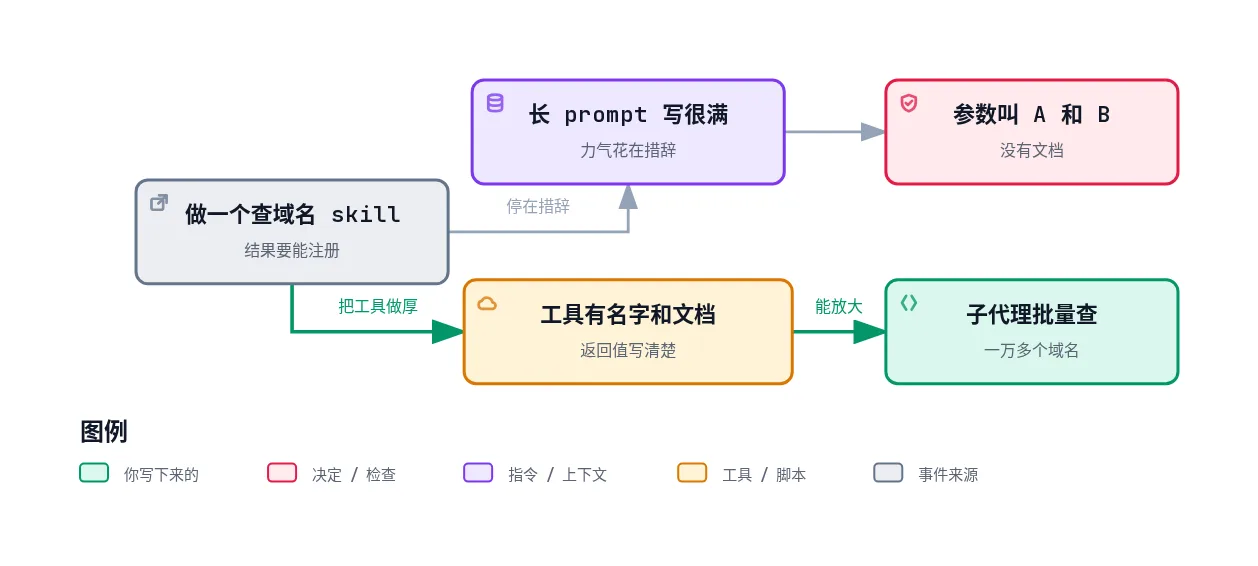
官方文档把第三层写得更硬。目录示例里,scripts/ 下的脚本标的是 executed, not loaded:执行,不把源码塞进上下文。reference.md 这类参考文件按需读。SKILL.md 建议控制在 500 行以内,正文写清什么时候去读旁边的文件。
我盯的是工具的名字和返回值。参数用域名、价格、可否注册这种词,旁边写清返回什么。人和模型读的是同一份函数说明。查询仍靠模型「想一下能不能买」,次数一多就会飘。
三、拆成能互相调用的小 skill
Austin 引用 Anthropic 对 skill 的四个词:composable, portable, efficient, powerful。可组合、换环境还能用、用到才加载、能带上可执行代码。Introducing Agent Skills 把这四个词列成条目。工程文 Equipping agents for the real world with Agent Skills 把 skill 定义成带说明、脚本和资源的文件夹,并说明不必一次读完。
他要的是小而可复用的 skill,彼此配合。一个巨型 skill 把所有事包在一起,改起来对不上。他自己的内容流水线最初是一个 content creation skill:出点子、写脚本、起草社交帖,全在里面。结果 it just became unmanageable。想改脚本怎么写,得动整个 skill,还不知道碰坏了哪一段。
后来拆成三个:YouTube idea research、YouTube script writer、LinkedIn post。每个只做一件事,而且可以互相调用。
他给了三个好处。问题好定位:小 skill 出了偏差,你知道进哪个文件夹。改进会复利:更新 YouTube idea research,用到它的流程一起升级;叠在一个大 skill 里的重复逻辑,修了一处,另一处还是旧的。复用:前面那个查域名的 skill,可以插进任何一条工作流,不必每条流程重写一遍查询。
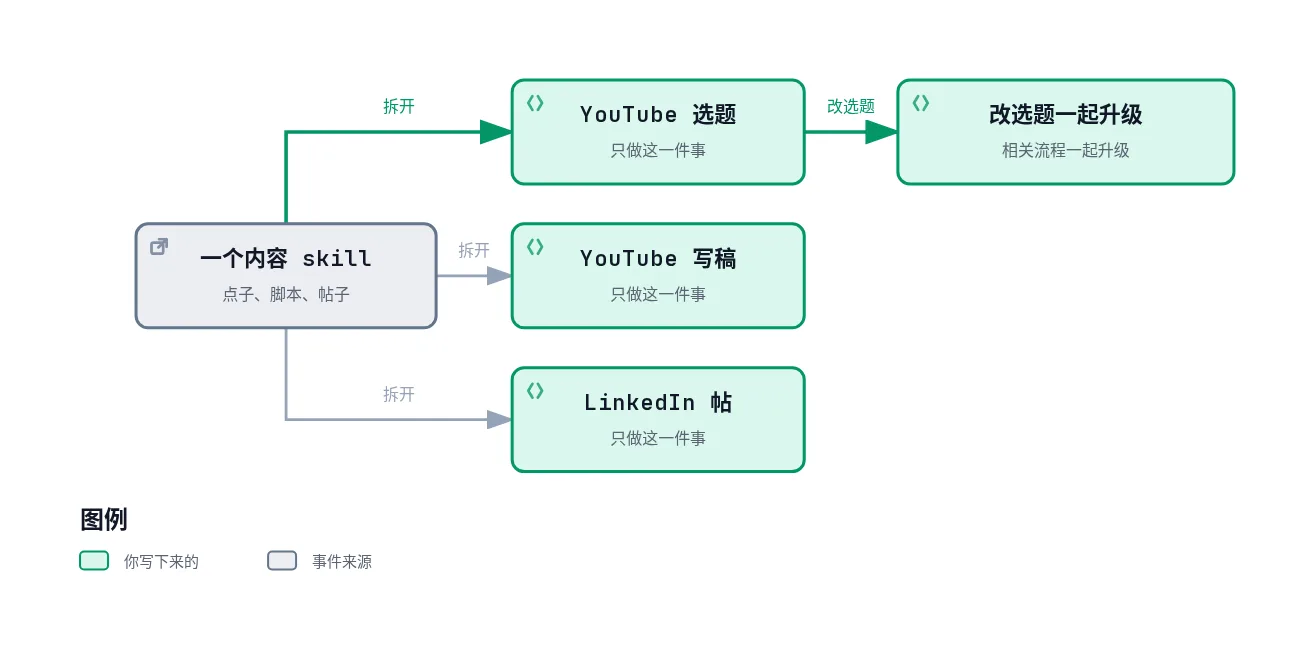
writing-for-agents 把长到注意力稀薄的文件叫 sprawl,把同一条规则放两处叫丢掉单一事实来源。巨型 skill 两样都占。拆开之后,一条流程只住一个文件夹,改动是一处编辑。
官方文档写了迁移时机,原句是:Create a skill when you keep pasting the same instructions, checklist, or multi-step procedure into chat, or when a section of CLAUDE.md has grown into a procedure rather than a fact. 你开始反复粘贴同一段指令、清单或步骤,或者 CLAUDE.md 里某一段已经从事实变成流程,就把它做成 skill。事实留在 CLAUDE.md 或 AGENTS.md,因为那一段每次会话都要在;流程进 skill,正文只在用到时加载。
本站根上的 AGENTS.md 就是这个形状:先选定集合,再给每个集合一行指针,长文怎么写放在 blog-article 里。那份 skill 目前在仓库的 .agents/skills/,服务的是读 AGENTS.md 的 Agent。Claude Code 自动发现的位置是另一处:项目里的 .claude/skills/<name>/SKILL.md(提交给团队),或个人的 ~/.claude/skills/<name>/SKILL.md。同一条原则:主文件保持能读完,分支在触发时再打开。加载差异我写在 AGENTS.md 那篇。
四、模式一:脚本放进文件夹
模式一来自 Barry 的用法,落在工具层。模式二是文档里的两个调用字段,Austin 在视频里单独讲。
Barry 在 AI Engineering Code Summit 的片段里说:We kept seeing Claude write the same Python script over and over again to apply styling to slides. Claude 一场一场地重写同一段给幻灯片套样式的 Python。他们把脚本存进 skill 文件夹。Austin 的转述是:下一场不必重写,it just reruns it。
代码给定同样的输入,就给出同样的输出。模型会解释、会猜、会花 token。Austin 把替换说成 trading AI tokens for code compute, which is cheaper, faster and repeatable。能用代码算完的那一段,交给代码,更便宜、更快、能重复。他的经验法则是 if you can use code instead of AI, you should。代码可以让 AI 写一次,之后一直复用。
我给博客配图就是这个形状。spec 是输入,scripts/render-blog-diagram.mjs 是确定的计算,同样的 spec 得到同样的图。这段由脚本重放,模型负责决定现在该出图,然后调用它。
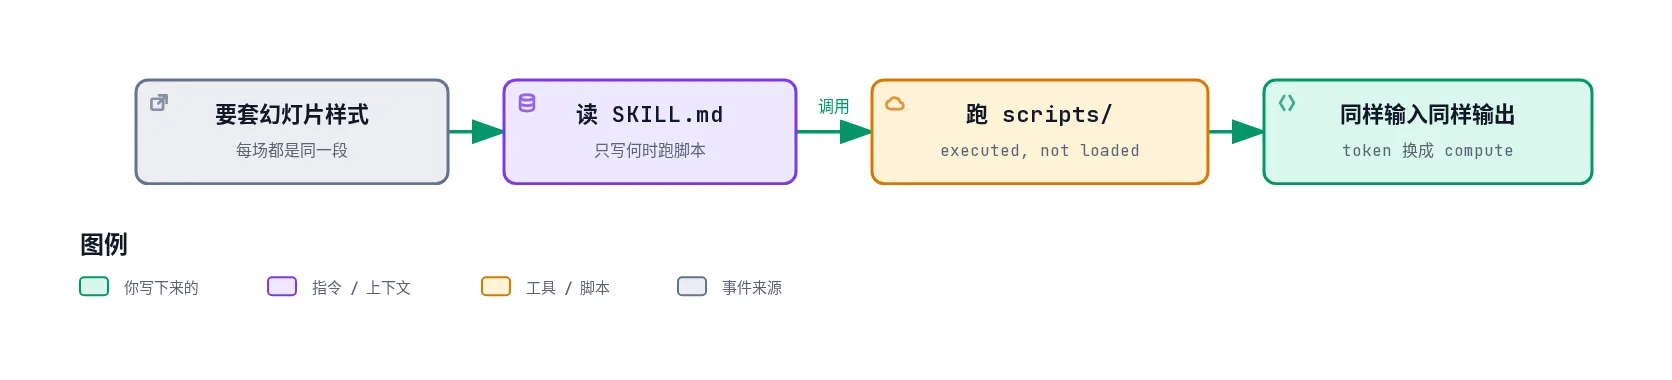
目录和官方示例同一结构。SKILL.md 写何时跑、跑完长什么样;scripts/ 放脚本。正文用 ${CLAUDE_SKILL_DIR} 指向这份 skill 自己的目录,放在个人目录、项目目录或插件里都能解析到。allowed-tools 可以预批准这一次调用,例如 Bash(${CLAUDE_SKILL_DIR}/scripts/render.sh *)。授权只在触发该 skill 的那一回合有效,下一条消息会清掉。再次调用时,这一回合重新授予。脚本被执行,源码不进上下文。
---
name: render-diagram
description: 把博客的 archify spec 渲成白底 WebP。用户要求给长文配图、补 diagram、或说「出图」时使用。
allowed-tools: Bash(${CLAUDE_SKILL_DIR}/scripts/render.sh *)
---

正文还缺 WebP 时才跑。完成的标志:`public/images/` 里有对应 `.webp`,文中用根路径引用。

运行 `${CLAUDE_SKILL_DIR}/scripts/render.sh`,参数是 spec 路径和 png 输出路径,再转成 WebP。
这是我会放进 .claude/skills/render-diagram/ 的形状,还没有提交成 Claude Code 的 skill。.claude/commands/*.md 仍能当斜杠命令用,官方已经把旧命令并进 skills。新写的流程我放 skill 目录,因为旁边能放 scripts/ 和 reference.md。
材料每次不同、步骤固定时,文档还有一种动态注入:用叹号加重音号包住要先跑的命令,让输出替换这一处。入门示例是独占一行的 git diff HEAD,Claude 看到的是 diff 本身。查域名、渲图这种计算本身固定的,仍然放 scripts/。
五、模式二:规定谁能调用
默认你和 Claude 都能调用。你输入 /name,Claude 在对得上 description 时自己加载。Austin 说 Anthropic 另外留了两个字段,多数人没听过。下面两个字段是 Claude Code 文档里的调用开关;别的 Agent 是否认同一套 frontmatter,以各自文档为准。
user-invocable: false:从斜杠菜单藏起来,你输入 /name 也不会跑,只留给 Claude。官方给的例子是 legacy-system-context 这种背景知识:解释旧系统怎么工作,没有一个值得你亲手敲的动作。它不阻止 Claude 调用。description 仍然常驻上下文,正文在用到时加载。
disable-model-invocation: true 方向相反。Austin 的例子是 a skill that sends a message or deploys a new version of your code to production:发消息,或把新版本部署到生产。官方表比视频多一列:设了这个字段,Claude 不会自己调用,description 也不进上下文,完整正文只在你调用时加载。文档举的命令是 /commit、/deploy、/send-slack-message。
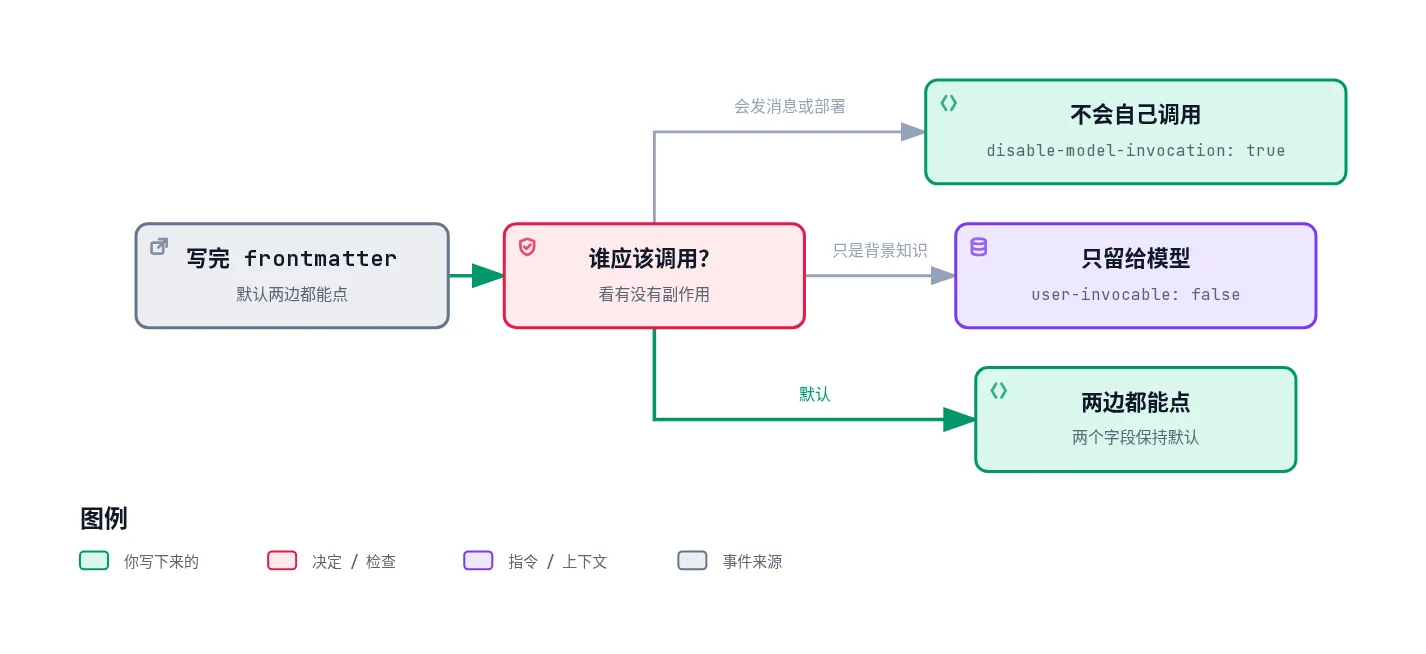
对照是这张表。
| frontmatter | 你能调用 | Claude 自己调用 | description |
|---|---|---|---|
| 默认 | 能,/name | 能 | 常驻上下文 |
disable-model-invocation: true | 能 | 不会自己调用 | 不进上下文 |
user-invocable: false | 不能,菜单里也没有 | 能 | 常驻上下文 |
视频把第二个字段说成只有你能跑、模型不能。文档的措辞是 Not on its own。还有两处按文档写进设计,视频里没展开。
消息开头的 /deploy staging 会直接跑这个 skill。写在一句话中间,例如「可以的话 /deploy 到预发」,不会直接跑,但算你授权 Claude 在这一回合里调用。斜杠命令要单独成词,后面不黏标点;Claude 根据这句话判断要不要在这一回合执行。要讨论这个命令本身,把斜杠拿掉。
Claude 若仍想自己调用一个设了 disable-model-invocation: true 的 skill,Claude Code 会拦住,并要求它不要用别的办法把部署步骤重做一遍,改口让你自己输入 /deploy。副作用收在这条命令里。
本站发公众号草稿的 wechat-night-purple 会跑 wenyan publish,只进草稿箱,已经是对外动作。它现在住在 .agents/skills/,frontmatter 里还没有 disable-model-invocation。交给 Claude Code 时,我会放到 .claude/skills/,并加上这个字段,避免模型对上 description 就自己发。旧接口的形状、某次迁移的历史约定,则用 user-invocable: false,让它在相关改动里出现,同时不占斜杠菜单。
六、跑完问一句:要不要写进 skill
一句 prompt 在对话关掉时就停了。skill 文件还在。每次用完,都有一次把它写得更具体的机会。
视频里 Anthropic 工程团队的原话是:Our goal is that Claude on day 30 of working with you is going to be a lot better on Claude on day one. 字幕是 better on,没有 than。意思是一起工作到第三十天,要比第一天强一截。格式上的保证是:写进 skill 的东西,之后的会话还能用。
Austin 只留一个问题。输出不满意时问:Is this a one-time fix or should this be in the skill forever? 属于 forever,就更新 skill:Add the rule, the example, the edge case. 补规则、补例子、补边界。
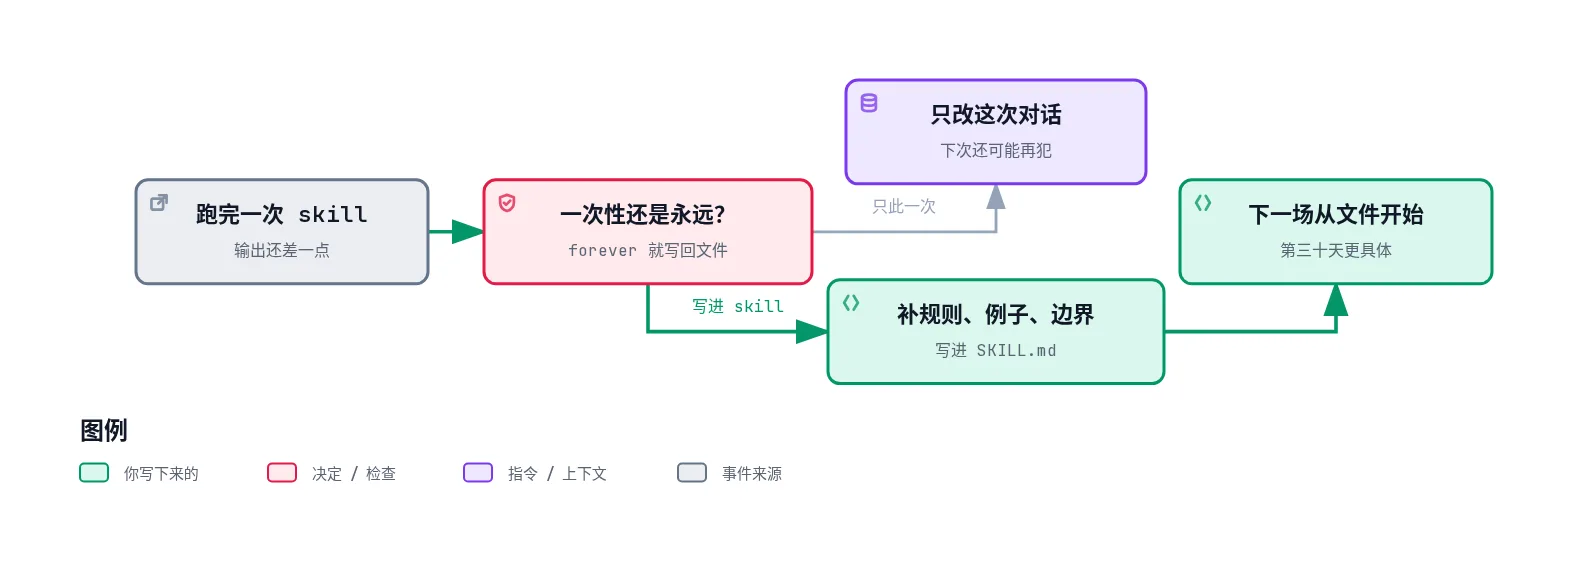
比如回信 skill 连续两次在结尾加 Hope this helps. 这次删掉就够了的,留在对话里。每封信都出现,就写进正文:收尾是一个具体的下一步。再补一封改好的例子。这就是规则、例子、边界各加一条。
他建议把刚才的来回交回去:Review the back and forth I just had after using this skill. Can we enhance the skill so this is handled automatically or we don’t make the same mistake again?
写回去时我按 writing-for-agents 收。目标行为直接写:「配图用 WebP,宽度不超过 2560」。必须留的红线,后面跟上要做的事:「密钥禁止提交;密钥放环境变量或未跟踪的本地文件。」每一步保留能检查的完成条件。第三十天多出来的是规则和例子。
文件和行为要分开。文档写明:调用之后,渲染过的正文留在后续回合里,Claude Code 不会在后面的回合重读文件。你改了 SKILL.md,要再调用一次;内容有变化时,新的全文会再附上。上下文被自动压缩时,每个已调用的 skill 最多带上最近一次的前 5,000 token,合计预算 25,000 token,从最近调用的开始装,装不下的旧 skill 会被整份丢掉。磁盘上的 skill 还在,压缩掉的是这场会话里的拷贝。
想对比改前改后,用文档里的 skill-creator 插件,拿同一批用例跑。想看哪些 description 每回合都占着上下文、却很少被用到,跑 /skill-doctor(v2.1.252 起)。进了技能列表的 skill,名字每回合都在;description 默认也在。设了 disable-model-invocation: true 的不进。技能一多,描述会按预算截短。
七、落到仓库里
四条规则可以收成四句。重复的流程写成 skill。skill 里把工具做厚。一个 skill 只做一件事,彼此调用。每次跑完,决定这处修正留不留在文件里。两个模式是 Claude Code 里工具层和调用字段的做法:确定的计算放进 scripts/,有副作用的命令只由人来点。文件夹本身可以给别的 Agent 用;哪些字段生效,看那个工具的文档。
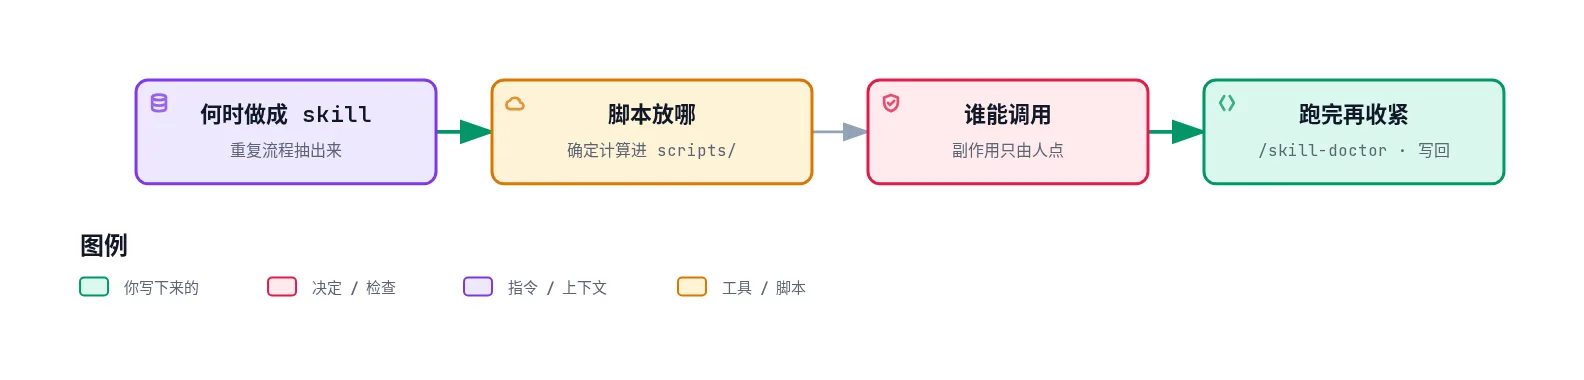
我按这个清单改自己的仓库:
- 翻
AGENTS.md和CLAUDE.md。还是事实的留下。已经变成步骤的,抽进.claude/skills/<name>/SKILL.md(给Claude Code)或.agents/skills/<name>/SKILL.md(给读开放约定的 Agent),原处改成一行指针,写清什么时候去读。 description第一句写触发。关键用例放在 1,536 字符截断能留住的前部。- 正文写步骤和完成条件。目标行为直接写出来。红线后面跟上要做的事。默认就会做的句子删掉。
- 同样输入要同样输出的,放
scripts/,用${CLAUDE_SKILL_DIR}调用。SKILL.md保持在 500 行以内,细节进reference.md。 - 发消息、提交、部署,在
Claude Code里加disable-model-invocation: true。背景知识加user-invocable: false。 - 输出偏离时先问:只改这一次,还是写进 skill。是后者,就补规则、例子或边界,然后再调用一次,让新正文进上下文。
- 跑
/skill-doctor,把从未调用、上下文成本又高的关掉。要留着但少占描述,用skillOverrides的name-only,不要靠删文件。
项目里给团队用的,提交 .claude/skills/。只在这台机器上跨仓库用的,放 ~/.claude/skills/。插件里的 skill 随插件走,命令名会带插件前缀。
Austin 的视频在 https://www.youtube.com/watch?v=qOvc9IUKEIc。字段以 Skills 文档 为准。Barry 和 Eric 的话都是视频里播放的 Anthropic 片段,我按字幕引用,没有另外找演讲全文。开放约定本身见 agentskills.io。