 山月行
拆解 LLM Agent Loop:一张图看懂智能体循环
最近在做 Agent 相关的东西,也天天在 Cursor 里让 Agent 改代码。用得越多越觉得,不管外面包装成什么产品,里面跑的都是同一个结构:一个循环。
我把这个循环画成了一张图,分成四层:用户侧、Agent Runtime 主循环、工具层、旁路。这篇就顺着这张图,一层一层讲清楚它为什么长这样。
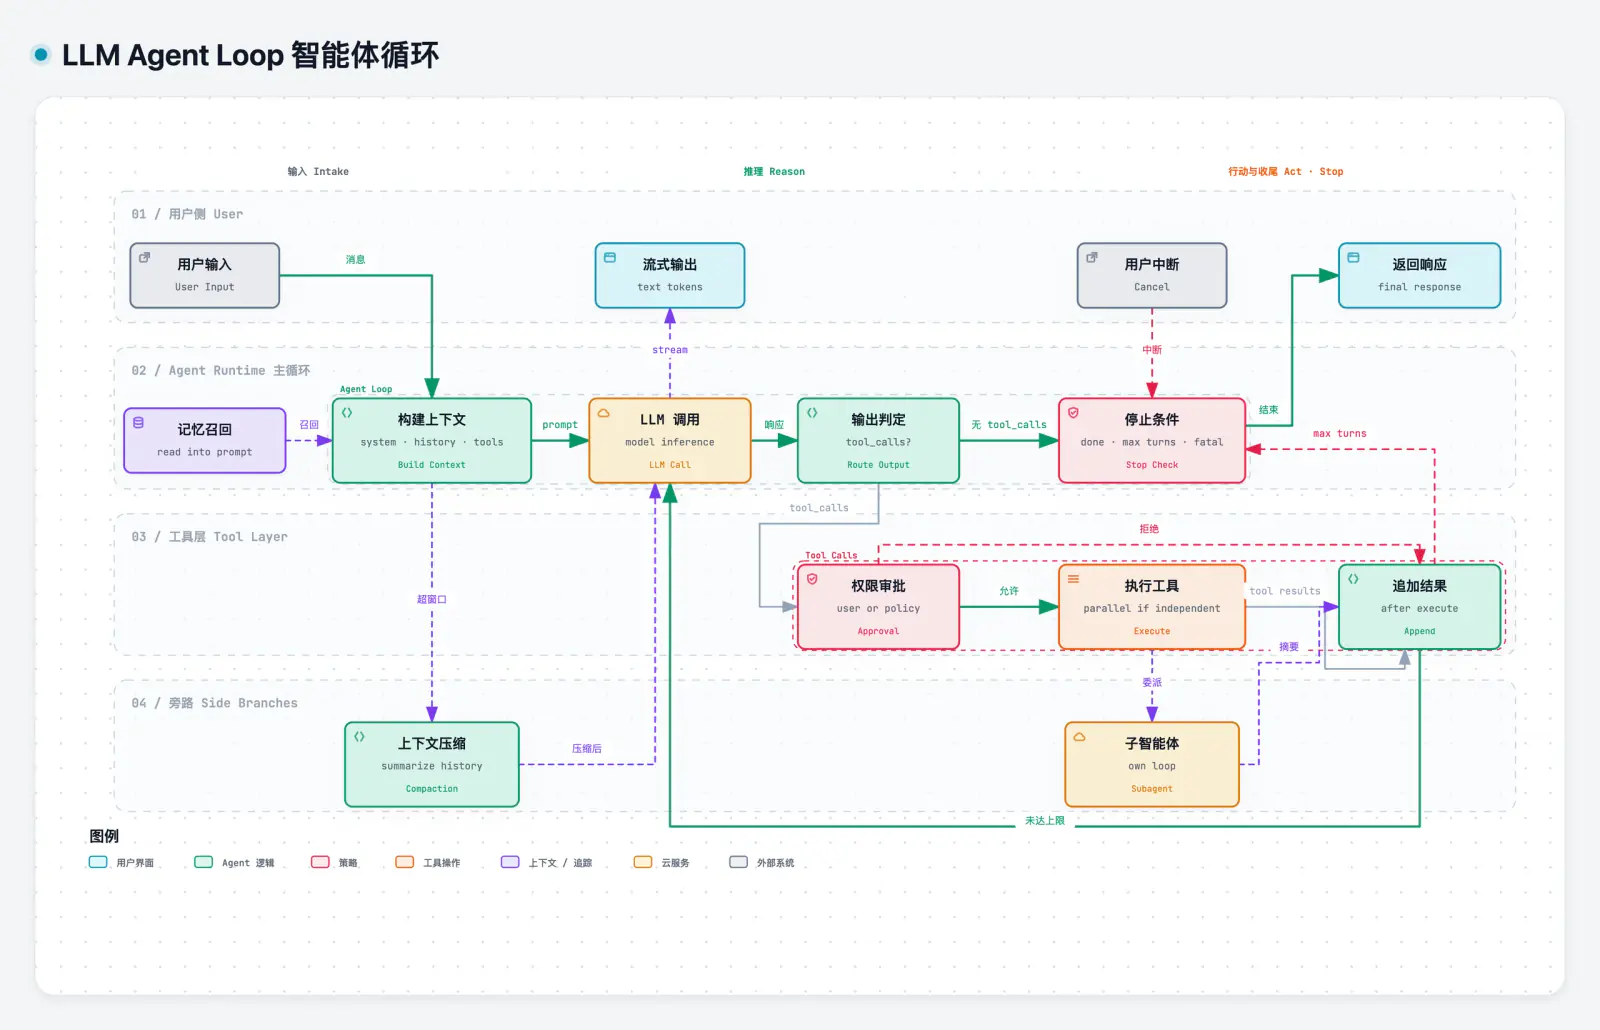
先交代一下图例的颜色:青色是用户界面,绿色是 Agent 逻辑,红色是策略,橙色是工具操作,紫色是上下文与追加,黄色是云服务(这里指模型推理),灰色是外部系统。后面几张局部图沿用同一套配色。
一、为什么是一个循环
普通的 LLM 调用是一问一答:拼好 prompt,发给模型,拿回一段文本,结束。
Agent 不一样。它要完成的任务往往需要”先看看再说”:先读文件才知道要改哪里,改完要跑测试才知道对不对,测试挂了还得再读报错。每一步做什么,取决于上一步的结果,而这个结果在调用模型之前是不知道的。
所以没法一次调用搞定,只能让模型说出它想做什么(tool_calls),由运行时去执行,再把结果喂回模型,让它决定下一步。这个”推理 → 行动 → 观察 → 再推理”的过程不断重复,就是 Agent Loop。
说白了,Agent 的”自主性”不在模型里,而在这个循环里。模型每次只负责回答一个问题:基于目前看到的一切,下一步做什么。
二、主循环:一轮是怎么转起来的
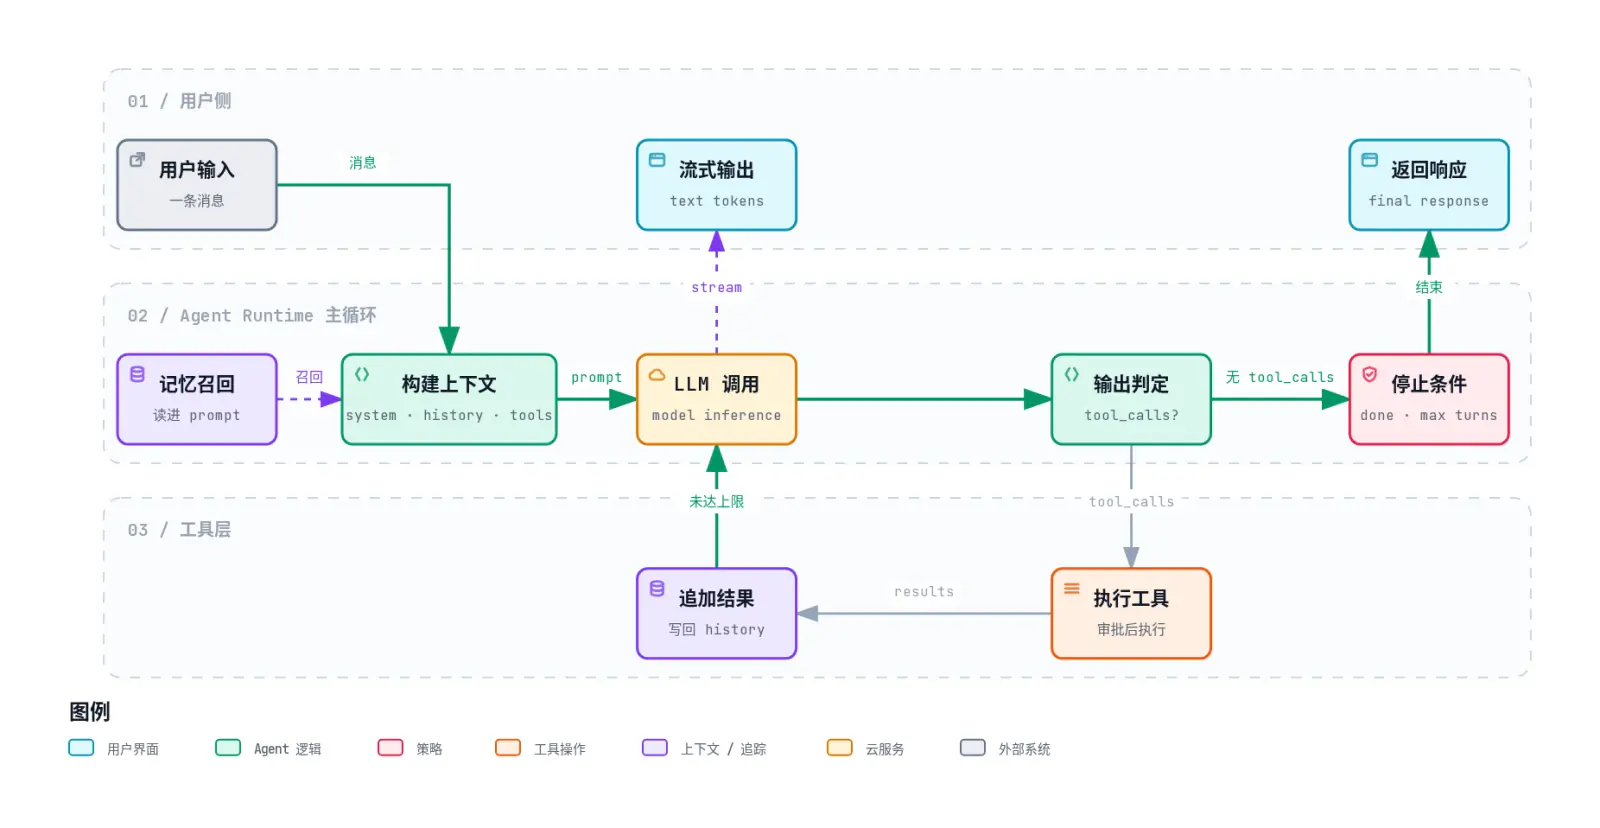
主循环有四个节点,按顺序是:
- 构建上下文:把
system prompt、历史消息(history)、可用工具的定义(tools)拼成这一轮要发给模型的输入。用户的新消息、召回的记忆,都在这一步进来。 - LLM 调用:一次模型推理。输出一边以流的形式推给用户侧,一边交给下一个节点。
- 输出判定:看模型这次的输出里有没有
tool_calls。这是整个循环唯一的分叉点。 - 停止条件:没有
tool_calls,说明模型认为自己做完了,进入停止判定,结束后把最终响应返回给用户。
有 tool_calls 就走另一条路:进入工具层执行,结果追加回历史,然后回到 LLM 调用,开始下一轮。
这里有个容易忽略的细节:图里”追加结果”的箭头指回的是 LLM 调用,而不是最开始的用户输入。也就是说,一次用户请求内部可能转很多轮,用户只发了一条消息,模型可能已经被调用了十几次。理解这一点,才能理解为什么 Agent 的成本、延迟和稳定性都跟”转了几圈”强相关。
三、工具轮次:审批、执行、追加
模型给出 tool_calls 之后,并不是直接执行。中间隔着一层权限审批。
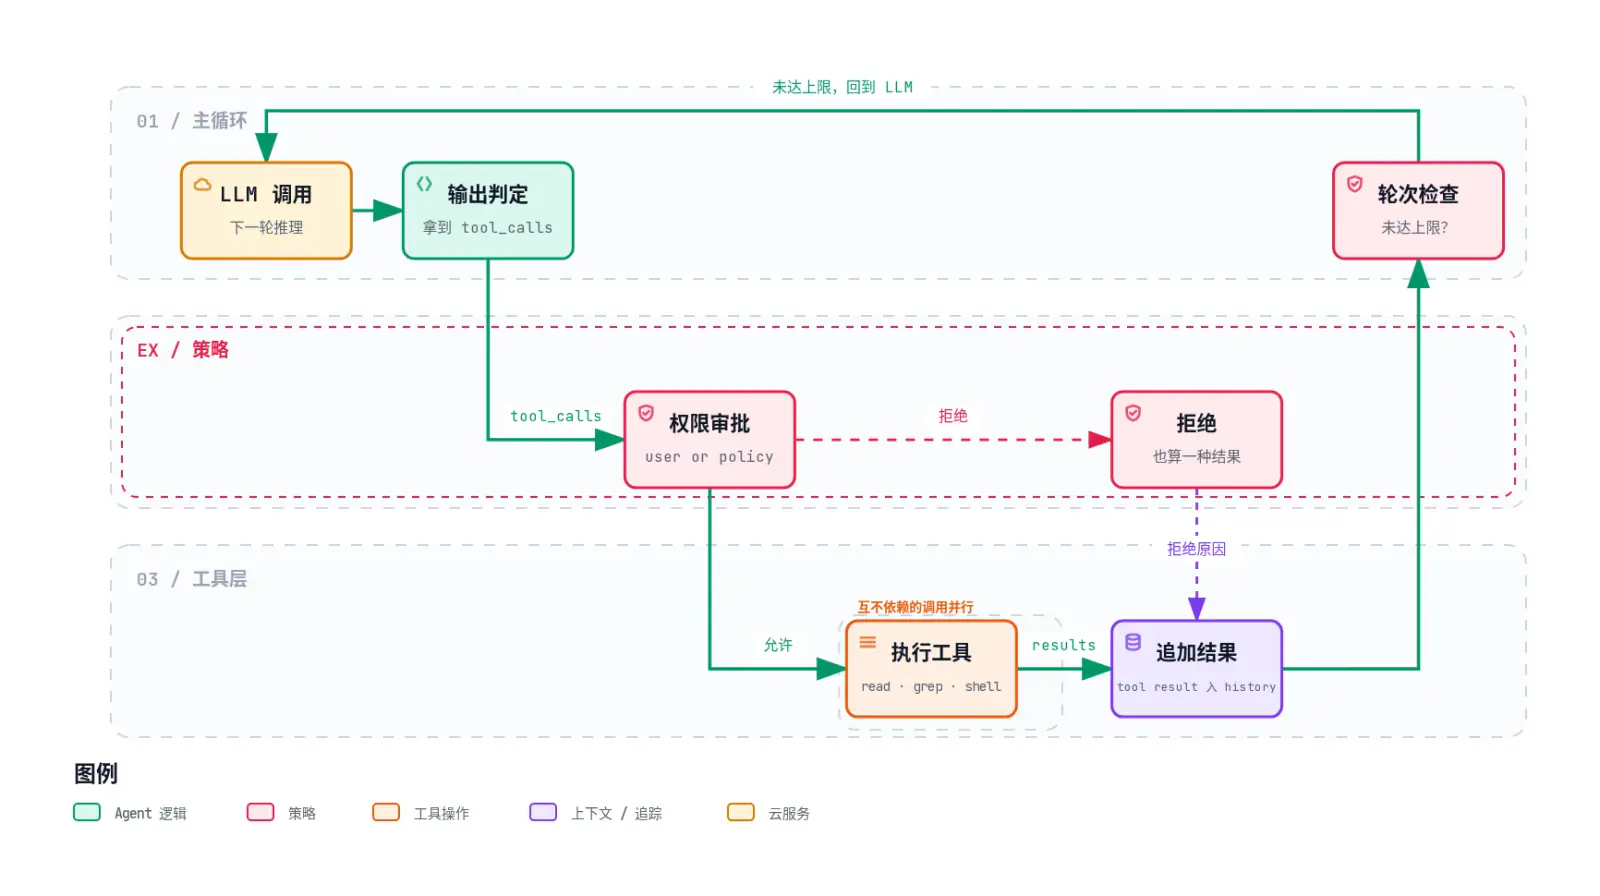
1. 权限审批:user or policy
审批的来源有两种:问用户,或者按策略自动决定。读文件、搜索代码这类只读操作,通常可以直接放行;执行 shell 命令、删文件、发请求这类有副作用的操作,就需要用户确认,或者匹配一份白名单规则。Cursor 和 Claude Code 这类工具都有类似的设计:有的命令直接跑,有的会弹出来等你点确认。
图里把审批画成红色的”策略”,放在工具层入口,意思很明确:模型只负责提议,执行权在运行时手里。模型可能会误判,可能被文件里的内容误导,所以不能让它的输出直接变成副作用。
2. 拒绝也是一种结果
注意图里的”拒绝”箭头:被拒绝之后,并没有中断循环,而是同样走到”追加结果”。
这个设计很重要。如果拒绝后直接报错退出,用户每拒绝一次,整个任务就断掉了。把”用户拒绝了这个操作,原因是 xxx”作为工具结果写回历史,模型在下一轮就能看到,然后换个思路:换一个更安全的命令,或者先问清楚再动手。
3. 并行执行:parallel if independent
模型一次可能返回多个 tool_calls,比如同时读三个文件。这些调用之间互不依赖,就可以并行执行,一轮的耗时从三次读取的总和变成最慢那一次。
关键在”independent”这个前提。读和读之间通常可以并行,但”写文件”和”读同一个文件”之间有先后关系,两个 shell 命令之间也可能有隐式依赖。比较稳妥的做法是:只读工具默认并行,有副作用的工具按顺序执行。宁可慢一点,也别让结果依赖执行时序。
4. 追加结果,然后回到 LLM
执行完的结果(或者拒绝原因)按顺序追加到历史里,每条结果要和对应的 tool_call 对上号。然后检查轮次:没到上限,就回到 LLM 调用,让模型基于新的观察继续推理。
工具结果本身也值得设计。一个命令输出几万行日志,原样塞回去,下一轮上下文就爆了。常见的做法是截断、只保留头尾、或者把大结果写进文件,只把路径和摘要告诉模型。
四、停止条件:四个出口
循环必须能停下来,而且要停得明白。图里的停止条件写了三个:done、max turns、fatal,再加上用户侧的”用户中断”,一共四个出口。
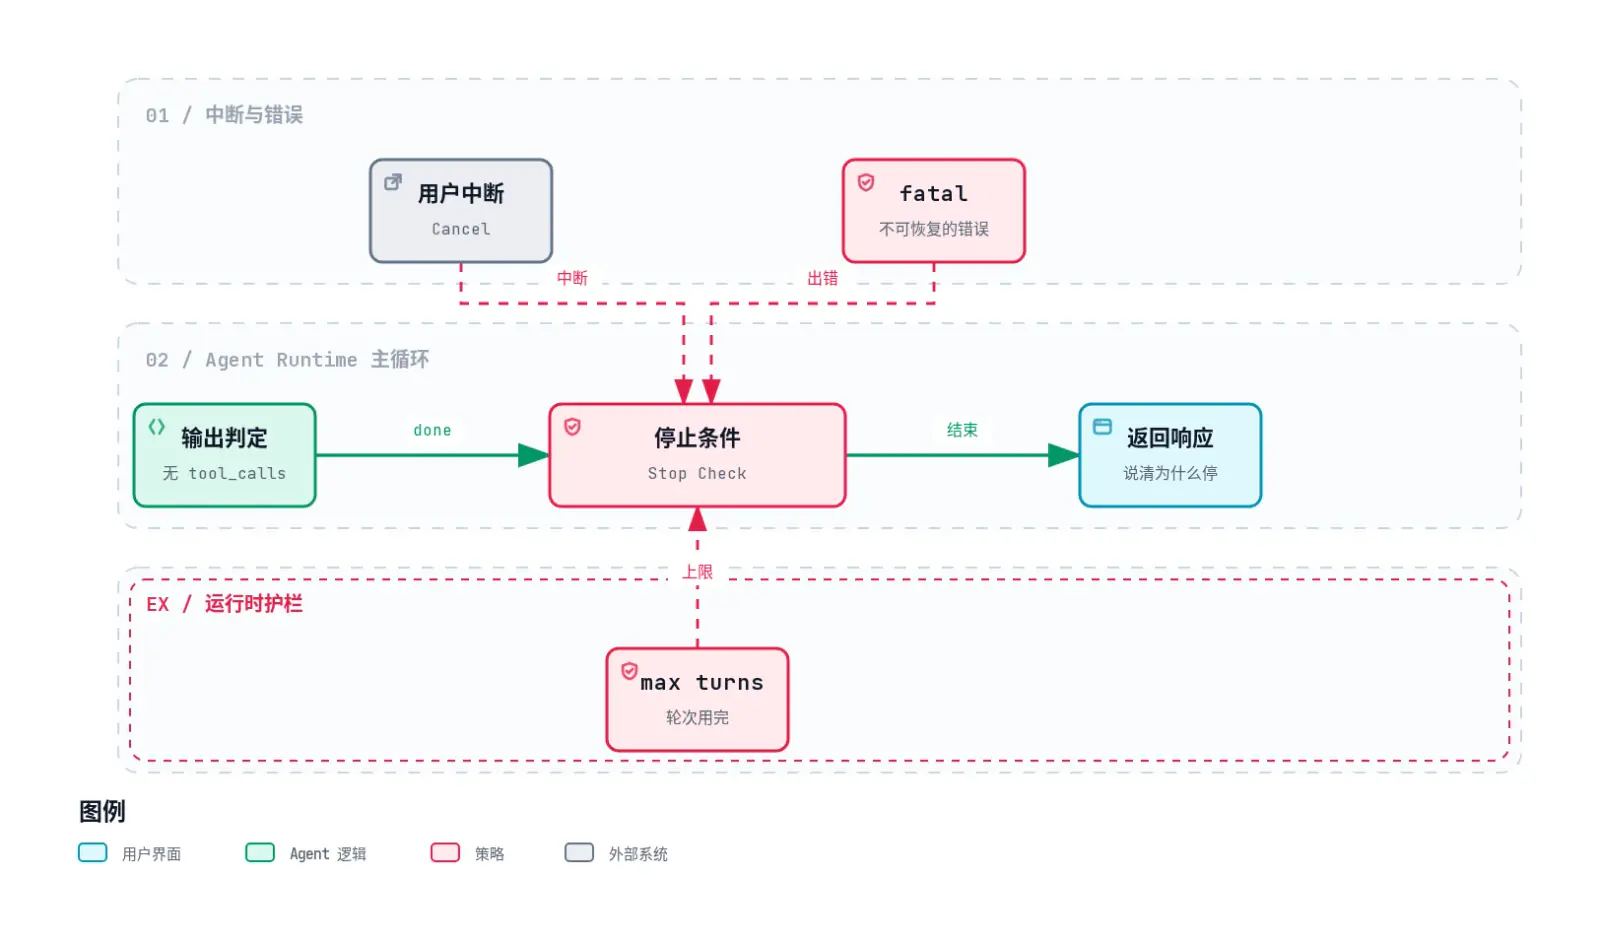
- done:模型不再请求工具,给出最终回答。这是正常结束。
- max turns:轮次达到上限。这是一道护栏,防止模型陷在”改了又错、错了又改”的死循环里。
- fatal:不可恢复的错误,比如模型接口持续失败、上下文压缩后还是放不下、运行环境挂了。
- 用户中断:用户点了取消。
后三种都不是”任务完成”,但处理方式应该和 done 一样认真。我的经验是两点:
第一,区分可恢复和不可恢复。一个工具执行失败不是 fatal,它应该作为结果写回去让模型处理;只有循环本身没法继续了才算 fatal。
第二,停下来的时候说清楚停在哪。达到上限时,告诉用户已经完成了什么、还差什么;用户中断时,已经做完的修改要保留,而不是悄悄回滚或者留下一半的状态。用户最怕的不是 Agent 停下来,而是不知道它停在了哪一步。
五、旁路:上下文压缩与子智能体
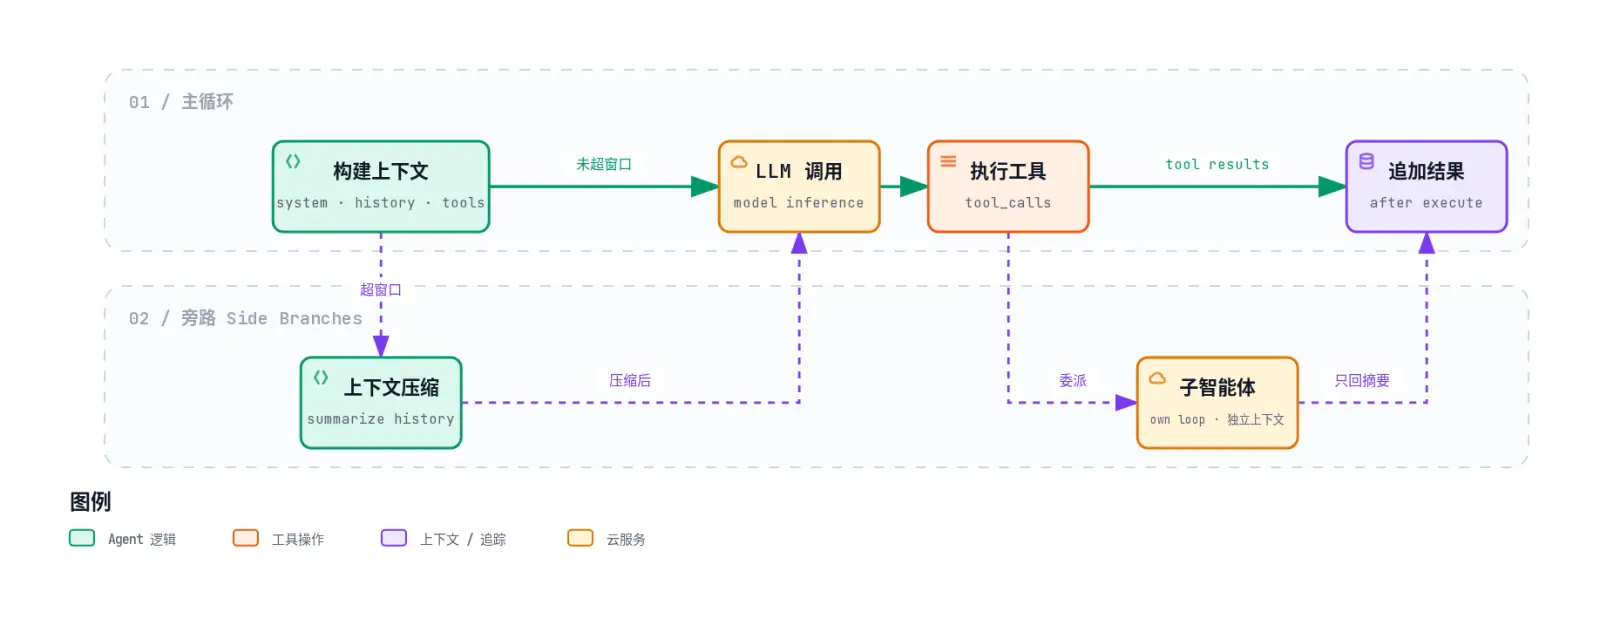
主循环之外,图的第四层画了两条旁路。它们不在每一轮都触发,但决定了 Agent 能不能处理长任务。
1. 上下文压缩
每一轮都在往历史里追加内容,转得越久,上下文越长,迟早会超出模型的窗口。
图里的处理是:构建上下文时发现超窗口,就先走一趟”上下文压缩”,把较早的历史总结成一段摘要,用摘要替换原文,再交给 LLM 调用。
压缩是有损的。哪些东西必须原样保留,需要想清楚:用户最初的目标和约束、已经改过的文件、尚未解决的问题,这些丢了,模型就会重复劳动,甚至推翻之前的决定。而中间过程里大段的工具输出,往往是最适合被压缩的部分。
2. 子智能体
另一条旁路是委派:执行工具时,把一个子任务交给子智能体。子智能体有自己的循环(own loop),有独立的上下文,跑完之后只把摘要交回来,作为一条工具结果追加到主循环里。
这样做的好处是隔离。比如”在整个仓库里找出所有调用某个接口的地方”,这个过程可能要搜很多次、读很多文件,如果都在主循环里做,中间结果会把上下文塞满。交给子智能体去做,主循环只收到一份结论,干净很多。
代价是信息损失和额外开销:主循环看不到子智能体的中间过程,摘要写得不好,主循环就会基于错误的结论继续。所以适合委派的,是那种边界清晰、结果容易描述的任务。
六、记忆召回与流式输出
还有两个小节点,放在主循环的两端。
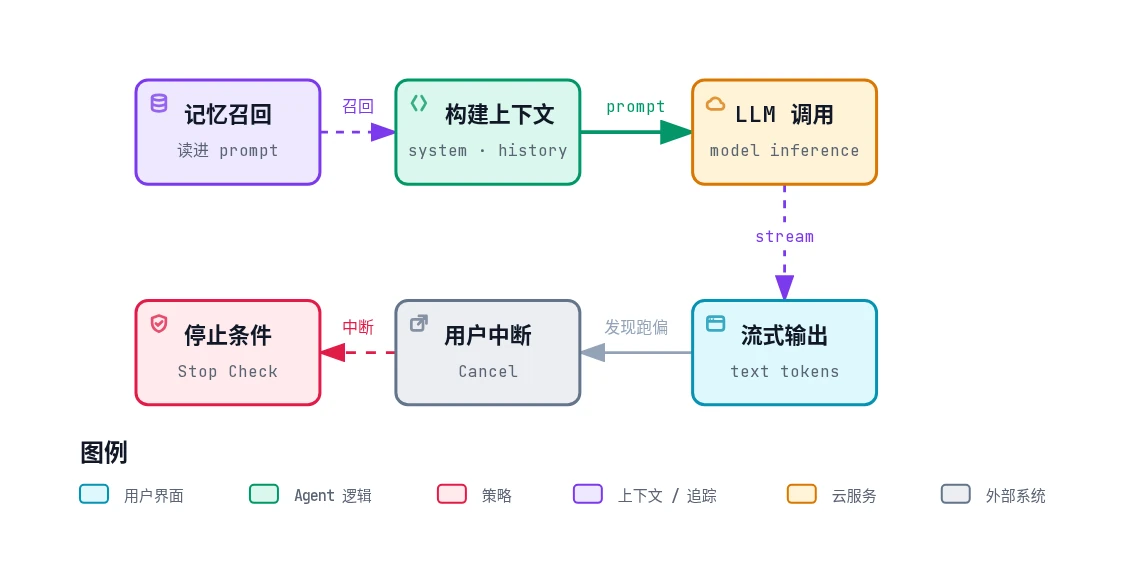
记忆召回在构建上下文之前,把跨会话的信息读进 prompt,比如项目约定、用户偏好、之前踩过的坑。Cursor 的 Rules、仓库里的 AGENTS.md,都可以看作这一类。它和上下文压缩是互补的:压缩解决的是”这次对话太长”,记忆解决的是”上次对话的东西这次还要用”。召回的内容也占窗口,宁可少而准,不要多而杂。
流式输出从 LLM 调用 引出一条虚线,把 token 实时推给用户。它不改变循环的逻辑,但对体验影响很大:一轮推理可能要好几秒,多轮叠加起来更久,用户需要看到 Agent 在想什么、正在调用哪个工具。流式输出也是”用户中断”的前提,用户看到方向不对,才能及时喊停。
七、用伪代码写一遍
把上面的图翻译成代码,大概是这样:
async function agentLoop(userInput: string) {
  const memory = await recallMemory(userInput);
  const history: Message[] = [{ role: "user", content: userInput }];

  for (let turn = 0; turn < MAX_TURNS; turn++) {
    if (signal.aborted) return stop("cancelled", history);

    let context = buildContext({ system, memory, history, tools });
    if (exceedsWindow(context)) {
      history.splice(0, history.length, ...(await compact(history)));
      context = buildContext({ system, memory, history, tools });
    }

    const reply = await callLLM(context, { onToken: streamToUser });
    history.push(reply);

    if (!reply.toolCalls?.length) return stop("done", history);

    const results = await runTools(reply.toolCalls, async call => {
      const ok = await approve(call); // user or policy
      if (!ok) return { callId: call.id, content: "用户拒绝了该操作" };
      if (call.name === "delegate") return runSubagent(call); // 只回摘要
      return execute(call);
    }); // 互不依赖的调用并行,有副作用的按顺序

    history.push(...results);
  }

  return stop("max_turns", history);
}
fatal 没有单独写出来,可以理解为 callLLM 或 compact 抛出的、循环本身接不住的异常,在外层统一收尾。
八、几点设计上的体会
最后总结几条我觉得比较实用的:
- 循环本身要简单。分叉点只有”有没有
tool_calls”一个,其他复杂度都放到工具、审批和旁路里。主循环越简单,越容易排查问题。 - 模型提议,运行时决定。任何有副作用的操作都要经过审批这一层,并且拒绝要作为结果回传,而不是中断。
- 每一种停止都要有交代。
done之外的三种出口,要让用户知道完成了什么、停在了哪。 - 上下文是最稀缺的资源。工具结果要裁剪,历史要压缩,大任务要委派,记忆要少而准,本质上都是在管理同一块窗口。
- 可观察性从一开始就要有。流式输出给用户看,每一轮的输入输出也最好留日志给自己看,不然出了问题只能靠猜。
Agent 产品之间的差别,很多时候不在循环的形状,而在这些细节上:审批怎么分级,工具结果怎么裁剪,压缩保留什么,什么时候委派。把这张图里的每个节点都想清楚,大部分问题就有了方向。